Der deutsche KI-Übersetzungsspezialist
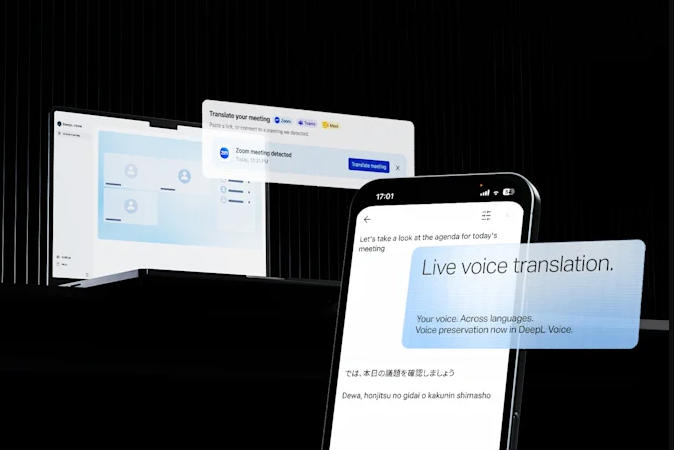
Deepl hat neue Sprachmodelle für seinen Echtzeit-Übersetzungsdienst Voice vorgestellt. Diese sollen neben dem gesprochenen Inhalt auch charakteristische Merkmale der Stimme wie Tonfall, Rhythmus, Sprechtempo und Intonation in die übersetzte Sprache übertragen. Dadurch sollen verschiedene Personen auch nach der Übersetzung anhand ihrer Stimme unterscheidbar bleiben.
Die Funktion zur Beibehaltung der Stimme steht zunächst für zwölf Sprachen zur Verfügung und kann bei Online-Meetings, persönlichen Gesprächen sowie über die Deepl API for Voice eingesetzt werden. Nach Angaben von Deepl werden dafür weder Sprachproben gespeichert noch dauerhafte Sprachprofile der Nutzer angelegt.
Neu ist zudem eine Desktop-App für Windows und MacOS, mit der Deepl Voice unabhängig von der verwendeten Videokonferenzplattform eingesetzt werden kann, wie Deepl
via Blog ausführt. Die Anwendung unterstützt Zoom, Microsoft Teams und Google Meet und soll laufende Meetings automatisch erkennen. Anwender können die Übersetzung wahlweise als Untertitel in einem Overlay lesen, als übersetzte Sprache anhören oder zwischen beiden Varianten wechseln.
Die Voice-to-Voice-Übersetzung für Online-Meetings über die Desktop-App ist ebenfalls allgemein verfügbar. Bereits angeboten wird die Sprachübersetzung für persönliche Gespräche sowie über die Deepl API for Voice. Eine browserbasierte Voice-to-Voice-Übersetzung für externe Meeting-Teilnehmer befindet sich dagegen weiterhin in der Betaphase.
(mw)